Métodos de Listas, o Poder de Dicionários/Sets e a Arte das Comprehensions
Se você quer trabalhar com Inteligência Artificial, Engenharia de Dados ou automações sérias, saber apenas o básico de listas e dicionários não vai cortar a lenha. Na vida real, você recebe dados fora de ordem, duplicados, incompletos e precisa transformar tudo em segundos.
Vamos dissecar os métodos essenciais de coleções, entender a mecânica por trás das operações de conjuntos e desmistificar a anatomia das Comprehensions para você nunca mais se enrolar. Prepara o café e bora codar!
1. Aprofundando em Listas
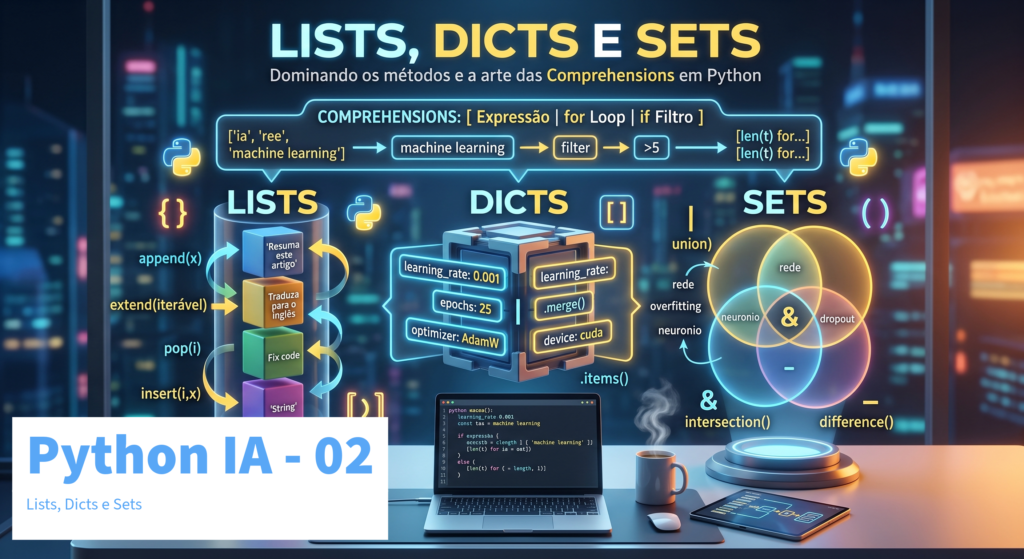
Listas são dinâmicas, mutáveis e contêm uma bateria de métodos prontos para manipular dados sem reinventar a roda. Saber qual método usar economiza tempo e evita bugs sutis.
| Método | O que faz? | A pegadinha / Comportamento |
|---|---|---|
append(x) |
Adiciona o elemento x no final da lista. | Se você passar uma lista, ele aninha ela como um elemento só dentro da original. |
extend(iterável) |
Desempacota e junta todos os elementos no fim da lista. | Ao contrário do append, ele funde as duas sequências em uma única lista plana. |
insert(i, x) |
Insere o elemento x na posição exata de índice i. | Empurra todos os elementos seguintes uma casa para frente. |
pop(i) |
Remove e retorna o item do índice (último item por padrão). | Excelente para implementar pilhas (LIFO) e filas de processamento de tokens. |
sort() vs sorted() |
Ordenação de dados (crescente/decrescente). | lista.sort() altera a lista original in-place; sorted(lista) cria uma cópia nova. |
Prática: Gerenciando um Pipeline de Prompts
# Fila de requisições de um chatbot
fila_prompts = ["Resuma este artigo", "Traduza para o inglês"]

# 1. append vs extend: preste muita atenção nisso!
novos_prompts = ["Corrija o código", "Gere um poema"]
fila_prompts.extend(novos_prompts) # Junta os itens um a um

# 2. insert: furando a fila com um prompt prioritário (índice 0)
fila_prompts.insert(0, "EMERGÊNCIA: Reiniciar sistema")

# 3. pop: retirando o próximo prompt para execução
prompt_executando = fila_prompts.pop(0)
print(f"Executando agora: {prompt_executando}")

# 4. count e index: auditoria de elementos
total_traducao = fila_prompts.count("Traduza para o inglês")
posicao = fila_prompts.index("Traduza para o inglês")
print(f"O item aparece {total_traducao}x e está no índice {posicao}.")

# 5. reverse: invertendo a lista in-place
fila_prompts.reverse()
2. Aprofundando em Dicionários e Conjuntos (Sets)
Tanto dicionários quanto sets são alimentados por Hash Tables (tabelas hash). Isso significa que buscar, adicionar ou verificar a existência de um elemento acontece em tempo constante — complexidade matemática O(1) —, ao contrário de uma lista que precisa conferir elemento por elemento (O(n)).
Dicionários: Métodos de Iteração e Fusão
Em modelos de dados modernos, raramente acessamos apenas uma chave por vez. Precisamos iterar em chaves, valores ou em ambos:
hiperparametros = {
    "learning_rate": 0.001,
    "batch_size": 32,
    "epochs": 10
}

# .items(): o método preferido dos desenvolvedores para desempacotar chave e valor no loop
for chave, valor in hiperparametros.items():
    print(f"Parâmetro: {chave} -> {valor}")

# .setdefault(): se a chave não existir, cria com o valor padrão; se já existir, não mexe
hiperparametros.setdefault("optimizer", "AdamW")

# Operador de união de dicionários | (nativo do Python 3.9+)
novas_configs = {"epochs": 25, "device": "cuda"}
config_final = hiperparametros | novas_configs # Sobrescreve 'epochs' para 25
Sets: A Matemática Pura a Favor dos Dados
Imagine que você precise comparar vocabulários de dois modelos ou limpar palavras repetidas em um dataset. Conjuntos possuem operadores matemáticos diretos:
| Operação | Operador | Método equivalente | Significado |
|---|---|---|---|
| União | A | B |
A.union(B) |
Junta tudo o que está em A ou em B (sem repetir). |
| Interseção | A & B |
A.intersection(B) |
Apenas o que existe simultaneamente em ambos. |
| Diferença | A - B |
A.difference(B) |
O que está em A, mas não está em B. |
| Diferença Simétrica | A ^ B |
A.symmetric_difference(B) |
O que está em um ou no outro, mas nunca nos dois ao mesmo tempo. |
vocabulario_treino = {"rede", "neuronio", "peso", "bias", "gradiente"}
vocabulario_teste = {"peso", "bias", "overfitting", "dropout"}

# Identificando palavras que o modelo nunca viu no treino (Out of Vocabulary)
palavras_novas = vocabulario_teste - vocabulario_treino
print(f"Palavras não vistas no treino: {palavras_novas}") # {'overfitting', 'dropout'}
3. A Anatomia Definitiva de uma Comprehension
Muitos iniciantes travam ao olhar uma List Comprehension porque tentam ler da esquerda para a direita de primeira. O segredo é entender as três partes fundamentais que compõem a estrutura:
- (2) O Loop (
for item in colecao): É o motor da máquina. O Python começa aqui, iterando sobre a fonte de dados. - (3) O Filtro opcional (
if condicao): Atua como uma peneira no final da linha. Se a condição for falsa, o item é descartado imediatamente. - (1) A Expressão de Retorno: É o que realmente entra na lista final. Você pode transformar o item, aplicar funções, fazer cálculos ou deixá-lo intacto.
Comparando Lado a Lado: O Jeito Tradicional vs. Comprehension
Queremos extrair apenas os comprimentos de textos que tenham mais de 5 caracteres:
textos = ["ia", "machine learning", "dados", "deep learning"]

# --- O JEITO TRADICIONAL (5 linhas, mutação de estado manual) ---
resultado_loop = []
for t in textos:
    if len(t) > 5:
        resultado_loop.append(len(t))

# --- O JEITO PYTHÔNICO (1 linha expressiva e declarativa) ---
resultado_comp = [len(t) for t in textos if len(t) > 5]
A pegadinha clássica: E se eu quiser um else?
Muita gente tenta colocar um else no final da comprehension e o Python cospe um erro de sintaxe. A regra é simples:
- Apenas filtrar? O
ifvai no final (ele decide se o item entra ou não). - Transformar com if/else (operador ternário)? O bloco vai no início, dentro da expressão de retorno.
scores = [0.92, 0.45, 0.78, 0.31]

# Se >= 0.5 classifica como 'Positivo', senão 'Negativo'
rotulos = ["Positivo" if s >= 0.5 else "Negativo" for s in scores]
print(rotulos) # ['Positivo', 'Negativo', 'Positivo', 'Negativo']
💡 Dica de Engenharia de Software: Comprehensions são elegantes, mas se ela ficar com mais de duas linhas ou tiver múltiplos loops aninhados, volte para o loop tradicional com funções auxiliares. Código legível sempre supera código “esperto” que ninguém entende depois de três semanas.
4. Limpeza Textual na Prática: Strings e Regex (re)
Strings em Python também são sequências imutáveis. Isso significa que fatiamento e métodos funcionam com extrema precisão para pré-processamento de linguagem natural:
import re

# Texto sujo simulando extração de dados brutos da web
raw_text = "  [ALERTA] Processo ID: 9942 falhou no servidor db-01 em 08/09/2026. Detalhes: timeout.  "

# 1. Limpeza rápida com métodos de string
clean_text = raw_text.strip().replace("[ALERTA]", "").strip()

# 2. Regex: extraindo apenas datas (dd/mm/aaaa)
padrao_data = r'\b\d{2}/\d{2}/\d{4}\b'
data_encontrada = re.search(padrao_data, clean_text)
if data_encontrada:
    print(f"Data da falha: {data_encontrada.group()}")

# 3. Regex: limpando caracteres especiais e deixando apenas palavras e números
apenas_palavras = re.sub(r'[^\w\s]', '', clean_text)
print(f"Texto normalizado: {apenas_palavras}")
As expressões regulares vão muuuito além do que vimos neste pequeno trecho do tutorial! Se você quer dominar o assunto, recomendo fortemente o livro Expressões Regulares: Uma Abordagem Divertida. Ah, e comprando pelo nosso link, você apoia o blog!
Você virou o mestre das coleções
Dominar listas com seus métodos de ponta a ponta, tirar proveito do ganho computacional dos sets/dicionários e ler uma comprehension de trás para frente são habilidades que diferenciam quem apenas brinca de programar de quem constrói pipelines de dados profissionais.
Desafio Prático
Pegue uma frase qualquer, use uma Dict Comprehension para mapear cada palavra única para o número de vezes que ela aparece e use um Set para descobrir as palavras em comum com uma segunda frase. O interpretador tá pronto esperando por você!